miércoles, 30 de marzo de 2016

Riesgo Relativo (Risk Ratio, RR). Razón de ventajas (Odds Ratio, OR). Texto y Video.


El riesgo relativo (risk ratio, RR, razón de riesgos) es el cociente de dos riesgos. El que existe en un grupo que sufre una exposición a un factor de riesgo comparado con otro grupo que no sufre esa exposición.

En el ejemplo que se verá, es el riesgo de contraer cáncer entre el grupo de fumadores comparado el riesgo de contraerlo del grupo de no fumadores.

También se puede usar en el contexto de situaciones sociales: por ejemplo el riesgo de delinquir entre quienes abandonaron tempranamente la educación comparado con el riesgo de quienes siguieron estudiando.

El riesgo relativo se puede calcular en el SPSS, pero las tablas tienen que tener una distribución muy precisa de variables y valores.

  • La variable independiente debe ir en filas.
  • La variable dependiente debe ir en columnas.
  • Los expuestos deben ir en el renglón superior
  • Los que sufren el evento de interés deben ir en la columna de la izquierda.

Si se usa esta disposición, el SPSS da correctamente el RR y su intervalo de confianza.

Si no nos acordamos de cómo van variables y celdas podemos recurrir a un calculador externo: Open Epi es una buena opción. Nos fijamos qué nos pide su formulario y apretamos calcular.

Lo mismo vale para el OR (odds ratio, razón de ventajas en SPSS). Se necesita la misma disposición de celdas, y si no la recordamos probablemente sea aconsejable usar Open epi.

Se adjunta una base y un vídeo que deberán ser descargados para poder trabajar con ellos. Están en un archivo rar listo para bajarse.


viernes, 25 de marzo de 2016

Numero necesario para tratar. Número necesario para dañar. Texto y Video.

El número necesario para tratar (NNT, number needed to treat) es una medida de eficacia de los tratamientos. También puede ser usado para medir la eficacia de políticas, p.e. contra la reincidencia penal, etc.

Responde a la pregunta ¿a cuántas personas debo tratar para mejorar a 1 más?


Para el cuadro de arriba (presentado como porcentajes), los tratados obtuvieron 2 éxitos más que los no tratados. Pero para obtener esos dos éxitos adicionales, debimos tratar a 100 personas.

Aquí el NNT = 100/2 = 50.

El NNT más pequeño que puede tener un medicamento es 1. Esto se daría si a) todo tratado se cura, y b) ningún no tratado se cura. Si un NNT es muy bajo, el medicamento es muy eficaz.

Si un NNT es muy alto, el tratamiento tiene muy poca eficacia por sobre el no tratamiento.


********

Una medida similar conceptualmente es el NNH (number needed to harm, número necesario para dañar). Se usa para medir efectos no deseados, daños, etc.


Un tratamiento puede ser bueno, pero tener efectos secundarios. Entonces podemos preguntarnos cuantos tratamientos son necesarios para que aparezca un efecto secundario adicional por sobre los que se presentarán en el grupo de control.

Los efectos no deseados de cualquier tipo los designamos por comodidad como malos resultados.

En la tabla de arriba (se presenta como porcentajes) tenemos 17 malos resultados adicionales en los tratados con respecto a los no tratados. Para obtener esos 17 casos adicionales fueron tratadas 100 personas. El NNH es de 100 / 17 = 5.9. Cada 5.9 personas adicionales tratadas, se obtiene un caso adicional de efectos no deseados.


********.

Usando calculadoras en línea, se pueden hallar NNT y NNH con sus intervalos de confianza.


********.

Se adjuntan dos bases (una para NNT y otra para NNH) conjuntamente con un video que muestra el trabajo previo en SPSS y la consulta en línea, en un archivo rar que debe ser bajado.


domingo, 20 de marzo de 2016

Cómo generar casos mediante sintaxis en SPSS. Texto.


Lo que sigue no tiene importancia para el analista práctico de datos.

Simplemente es cómodo para generar rápidamente muchos casos y luego adjudicarles valores aleatorios.

Si deseamos crear, digamos 98.000 casos, podemos recurrir a la siguiente sintaxis:


INPUT PROGRAM. 
LOOP #i=1 to 98000. 
COMPUTE id=#i. 
END CASE. 
END LOOP. 
END FILE. 
END INPUT PROGRAM. 
EXECUTE. 
Set seed = 1234.


Si usted abre un archivo de sintaxis nuevo, le pega la sintaxis de arriba 
y la corre, tendrá una base con 98000 casos y una variable llamada Id, que
toma valores consecutivos. 
 
El último comando, "set seed = 1234", no es necesario para la creación de
casos, pero si usted ha de crear variables aleatorias y desea que siempre
se creen los mismos números, deberá fijar la semilla de aleatorización en
un cierto valor cualquiera. Aquí se eligió 1234, pero se podía haber elegido
cualquier otro.


martes, 15 de marzo de 2016

Indice PHEEM: generación y chequeo de consistencia de dimensiones con Alfa de Cronbach (ejercicio sin solución)


El índice PHEEM fue diseñado para medir la calidad del trabajo y enseñanza que reciben los médicos cuando trabajan y cursan sus futuras especializaciones.

Se adjunta un .doc con el problema, un .xls con información sobre el índice, una sintaxis que genera una base sobre la cual se trabajará y, en forma suplementaria, dos artículos donde los interesados podrán enterarse más a fondo del índice.

Como parte del ejercicio se pide analizar la consistencia de conjuntos de ítems usando alpha de Cronbach.


https://drive.google.com/file/d/0B9C7VyfotFyJNXRmamYzM1YwdDg/view?usp=sharing

jueves, 10 de marzo de 2016

Alfa de Cronbach. Texto y video.

El alfa de Cronbach es una medida de interrelación de un conjunto de ítems.

Cuando intentamos medir un único aspecto "unidimensional" se supone que todos sus indicadores se correlacionan positivamente entre sí. "Unidimensional" está puesto entre comillas porque es un concepto que puede tener sus complicaciones.


Un autor (Klaas Sijtsma) sostiene que no debemos dar por descontado que, si hacemos un análisis factorial de los ítems, encontraremos una solución adecuada de un solo factor.
Según dicho autor "... all that alpha can reveal about the “interrelatedness of the items” is their average degree of “interrelatedness” provided there are no negative covariances, and keeping in mind that alpha also depends on the number of items in the test (...). 
"Alpha is not a measure of internal consistency. Neither is it a measure of the degree of unidimensionality".
Para dicho autor, el alfa de Cronbach no debe ser interpretado como una medida de consistencia interna sino, como se decía antes, como una medida del grado de correlación entre los ítems.
"Because this says very little if anything about internal consistency no matter how it is defined, one wonders why the internal consistency interpretation of alpha is so persistent."


Sean por ejemplo varias afirmaciones que intentan medir el nivel de empatía y sobre las cuales el entrevistado tiene que manifestar su acuerdo o desacuerdo:


item1: Me entristece ver a un extraño solitario
item2: Me siento emocionalmente involucrado en los problemas de mis amigos
item3: Si veo una persona llorando, eso me trastorna
item4: No me siento bien cuando veo a otros deprimidos
item5: Me siento triste cuando veo a viejos sin nadie que los ayude
item6: Yo permanezco tranquilo cuando los otros se excitan (Invertido)
item7: Me cuesta entender cómo otros se emocionan con tonterías (Invertido)


Se pretende que todos estos indicadores miden empatía. En los 5 primeros ítems, manifestar acuerdo expresa empatía, y en los 2 últimos es el desacuerdo el que la manifiesta.

Si hemos de formar un índice de empatía reuniendo los 7 ítems, el 6 y el 7 deben ser invertidos.

Una vez que todos los ítems están en el sentido correcto, si todos miden lo mismo, habrá correlaciones positivas entre ellos: cuando aumentan unos, aumentan los otros. Esta podría ser la gráfica de las relaciones entre los ítems luego de invertir los ítems que corresponda:


El alfa de Cronbach en algún sentido mide y resume el grado de correlación entre los distintos ítems.

El alfa de Cronbach toma usualmente valores entre 0 y 1, aunque podría tomar valores negativos en el caso de ítems con correlaciones negativas entre sí, lo que no es esperable en la confección de índices.

Convencionalmente se consideran el alfa de Cronbach según estos criterios:
0.7 - 0.8 aceptable
0.8 - 0.9 bueno
0.9 - 1 excelente.

Pero los criterios anteriores son reglas generales que deberán ser usadas según las circunstancias.

¿De qué depende el valor del Alfa de Cronbach? a) de la correlación entre los ítems, y b) del número de ítems: cuántos más ítems más tiende a subir el alfa de Cronbach.

En  nuestro ejemplo estamos midiendo empatía con un set de 7 ítems. Concibamos a nuestos ítems como 7 posibles ítems elegidos al azar de una población de infinitos ítems.

Podemos pensar el alfa de Cronbach como la correlación promedio entre los puntajes dados por todos los sets de igual cantidad de ítems.

O sea: para la cantidad de 7 ítems podríamos tener infinitos conjuntos de 7 ítems. Estos nos darían infinitos puntajes para la población medida con estas escalas. Si promediáramos las correlaciones entre esas infinitas medidas, nos daría el alfa de Cronbach.

***

Output principal del Alfa de Cronbach

En el vídeo adjunto se muestra como pedir un alfa de Cronbach. Aquí se enfatizará en las principales salidas.


En la salida usualmente lo más relevante es el valor del Alfa de Cronbach (aquí 0.858), y las columnas señaladas.

La columna correlación total de elementos corregida, nos da la correlación de cada ítem con la suma del resto de los ítems. Aquí vemos que el ítem8 correlaciona muy pobremente (r = 0.090) con la suma del resto de los ítems. Eso nos sugiere sacar el ítem8, que encaja mal.

La columna "Alfa de Cronbach si el elemento se ha suprimido", nos indica cuál sería el valor del alfa si cada uno de los elementos fuera retirado del conjunto. Aquí vemos que si retiramos el ítem8, el alfa de Cronbach pasaría de su valor actual, 0.858 al valor de 0.912. Nos reafirma la conveniencia de eliminar el ítem8.

Entonces aquí sacaríamos el item8 del índice y volveríamos a pedir el nuevo alfa de Cronbach.

Una vez que hemos elegido los ítems que quedarán en definitiva, procedemos a calcular el índice promediando o sumando los ítems.


Sigue video que muestra el cálculo del Alfa de Cronbach en SPSS, y la base sobre la cual se calcula.


https://drive.google.com/file/d/0B9C7VyfotFyJaUZRSVp0d1Fxb28/view?usp=sharing


sábado, 5 de marzo de 2016

Fuerza de la asociación en relaciones lineales entre variables de escala. Bootstrap. Texto y Video.


Se recomienda entonces, para los resultados principales, dar medidas de tamaño del efecto e intervalos de confianza para ellas.

Veamos el caso de variables de escala que se relacionan linealmente.


Cuando tenemos dos variables de escala que se relacionan linealmente, y nos centramos en su correlación, la medida de asociación habitualmente usada es la r de Pearson. 


"The index of choice in a correlational design is the product–moment correlation coefficient, r, which is calculated in the traditional fashion, and is obtainable in the standard output of statistical packages; r is a widely used index of effect that conveys information both on the magnitude of the relationship between variables and its direction (Rosenthal, 1991). The possible range of r is well known: from −1.00 through zero (absolutely no relationship) to +1.00." (1)


¿Y cómo establecer para la r de Pearson su intervalo de confianza? Una posibilidad es recurrir a algún calculador online:VassarStats, SDM, etc. Otra posibilidad es hacer uso del bootstrapping. Ambas formas de calcular el intervalo de confianza se muestran en este vídeo.


Ahora bien, cuando creamos un modelo de regresión lineal, es imprescindible reportar también otra cantidad: cuanto cambia la variable dependiente por cada unidad de cambio en la independiente. 
Pero para tomar esta temática, será necesario ver antes regresión lineal.


lunes, 29 de febrero de 2016

Cómo medir la fuerza de la asociación en tablas cruzadas de 2 x 2 y mayores. Texto.


James Rosenthal es un viejo autor a quien vale la pena leer. Yo diría que es un clásico.

Lo que sigue se apoya fundamentalmente en Rosenthal, pero también algo en otros autores. Lo dicho vale esencialmente para las ciencias sociales, y no para otras ciencias en donde se podrán encontrar habitualmente fuerzas de asociación mayores o menores.

¿Cómo informar la fuerza de la asociación en una tabla de 2 x 2?


Diferencia de porcentajes.


En la tabla de 2 * 2 de arriba los porcentajes están calculados horizontalmente. Los porcentajes en la tabla están todos entre 10% y 90%. En estas condiciones encuentra razonable usar la diferencia de porcentajes, e informar por ejemplo así: Entre los no pobres, hay un 30% más de personas que completaron liceo (55% - 25%).

Es un tema algo espinoso catalogar de diferencias de grandes, medianas o pequeñas: hasta cierto punto depende de las disciplinas lo que es grande y lo que es chico. Y dentro de las disciplinas del área específica que se está estudiando.

De todas maneras, a modo de orientación, Rosenthal maneja estas cifras:


Cociente de porcentajes

Si en la tabla de 2 * 2 una de las cantidades está por debajo de 10%, se inclina por el cociente de porcentajes (RR por risk ratio, o también riesgo relativo, como se lo conoce en medicina).


Si no lo hiciera así, la diferencia de arriba debería llamarla chica. Pero el efecto es grande: el que no se vacuna tiene 9 veces más riesgo de enfermarse.

En definitiva, si una de las cifras es menor al 10 %, se inclina por el cociente de porcentajes o RR (riesgo relativo).

RR varía de 0 a infinito.

Nótese que si el riesgo de enfermarse es 9 veces mayor entre quienes no se vacunaron con respecto a quienes sí se vacunaron, el riesgo de enfermarse es 1/9 entre quienes se vacunaron con respecto a quienes no se vacunaron.

Según cómo se haga la cuenta, RR es 9.0 o 1/9. Es la misma fuerza de asociación, expresada de dos formas distintas. Dicho de otra manera, esas fuerzas de asociación expresan lo mismo, pero se toman distintas categorías de referencia.

¿A qué llamaba Rosenthal fuerza de asociación pequeña, grande, etc.? Veáse.


Odds Ratio


Rosenthal apreciaba mucho la medida OR para las tablas de 2 * 2. Es bueno comprender esta medida: se usa también obligatoriamente en regresión logística y en estudios de caso - control. Ahora bien, muchos no gustan de ella porque no es tan intuitiva como el RR.

Odds Ratio es un ratio, un cociente, de odds.

Y las odds son una forma de expresar la probabilidad. Si tiramos un dado, la posibilidad de que salga un 4 es de 1 en 6. Probabilidad = 1/6. Esta probabilidad se puede expresar como odds, que es el cociente entre la probilidad de que suceda un evento dividida la probabilidad de que no. Entonces el odd de que salga un 4 es de 1 contra 5. Odd = 1/5.

El OR es un ratio de odds.

Veámoslo ejemplificado en la tabla que sigue:


Acá las probabilidades de haber votado por el gobierno, entre quienes apoyan la ley, son de 30%. En cambiom expresado en odds, tenemos que son de 30/70.

Y las odds de haber votado por el gobierno entre quienes rechazan la ley son de 8/92.

Por eso  OR (odds ratio) = (30 / 70) / (8 / 92), y esto es igual al producto cruzado. OR = (30 * 92) / (70 * 8) = 4.93. Rosenthal lo consideraría fuerte en el contexto de las ciencias sociales.


OR varía de 0 a infinito. No hay asociación si OR es 1.

Cuando se habla de OR tiene que quedar claro cuál es el evento del que hablamos (aquí haber votado por el gobierno) y cuál el grupo de referencia (aquí rechazar la ley). Entonces podríamos decir que las odds de haber votado por el gobierno son 4.93 mayores en el grupo que apoya la ley que en el grupo de la rechaza.

Si se cambia el grupo de referencia, el OR pasa a ser el recíproco. Por ejemplo, el OR de 4.93 se transformaría en un OR = (1/4.93) = 0.203. Por ello un OR de 4.93 y un OR de 0.203 indican la misma fuerza de asociación.

Valen los mismos valores para lo que es una asociación débil, mediana, etc.


Tablas mayores a 2 * 2

Sigue una tabla de 3 * 2 con variables nominales. Para estas tablas Rosenthal plantea que una buena medida de asociación es la V de Cramer. La V de Cramer varía de 0 (no asociación) a 1 (asociación perfecta). Da una medida global del grado de asociación.

Ahora bien, más allá de establecer una medida del grado global de asociación, importa ver en qué celdas hay excesos o déficits marcados. En estas tablas es absolutamente imprescindible el análisis celda a celda, esto es, ver en qué celdas hay excesos relativos o carencia relativa de casos.


Para Rosenthal, el uso primario de la V de Cramer son tablas mayores a las de 2 * 2, pero pueden ser usadas en estas últimas.

(En las tablas de 2 x 2 hay otros autores que miran con desconfianza el uso de la V de Cramer si alguna de las distribuciones es muy desbalanceada, es decir si una de las categorías tiene menos del 10 % de los casos).


No disponiendo de datos de Rosenthal sobre cómo interpretar la V de Cramer, adjunto criterio de Rea y Parker.


Tablas con variables ordinales

La preferencia de Rosenthal es por tau B si la tabla es cuadrada, es decir si tiene igual número de filas y categorías.

Y si el número de categorías es distinto entre las variables, su preferencia es Tau C (1).

Es de hacer notar que tau b y tau c tratan de ver si existen relaciones crecientes o decrecientes, pero no sirven para medir la fuerza de una relación curvilínea.


En ciencias sociales, se pueden usar estos criterios para llamar débil, moderado o fuerte a un tau:

tau de aproximadamente 0.10 ........ débil
tau de aproximadamente 0.30..........moderado
tau de aproximadamente 0.50 .........fuerte.


Estos valores deben tomarse solamente como orientativos, y pueden haber áreas dentro de las disciplinas que usen distintos criterios.


(1) Tomado de James Rosenthal "Statistics and Data Interpretation for Social Work".


jueves, 25 de febrero de 2016

P-valores ("sig") y expectativa de replicación exitosa en futuros estudios. Texto.


Cuanto más chicos sean los p-valores, mayor es nuestra expectativa de que podamos replicar exitosamente nuestros resultados en posteriores estudios. Por replicación exitosa entendemos aquí llegar a resultados similares: si encontramos que existía un efecto, volver a encontrarlo.

Sigue un interesante artículo que muestra cuales fueron las probabilidades de replicación exitosa dado un conjunto de p-valores.

Sorprende la baja tasa de replicación.

Vale la pena leer el artículo y es muy corto!


http://blog.minitab.com/blog/adventures-in-statistics/p-values-and-the-replication-of-experiments

sábado, 20 de febrero de 2016

Más sobre P Valores, Intervalos de confianza, reflexión sobre la importancia práctica y sobre posibles sesgos del estudio. Texto.


En un artículo sito en http://ptjournal.apta.org/content/81/8/1464.full, escrito por Jonathan A C Sterne y George Davey Smith, sus autores invitan a publicar los resultados de los análisis estadísticos siguiendo algunas normas que parece de interés explicar y comentar.


Comentarios:

1) Si estamos estudiando una relación, describirla solo como "estadísticamente significativa" no es aceptable. Además habrá que indicar tamaño de los efectos e intervalos de confianza.

2) Se requieren intervalos de confianza para los principales resultados de los estudios. El autor tiene preferencia por intervalos de confianza al 90 %.

Al momento de interpretar los intervalos de confianza se debe hacer foco en la importancia práctica de los hallazgos.

3) El p valor se interpretará como un índice de la evidencia contra la hipótesis nula. Cuanto más pequeño el p valor, más evidencia.

4) El autor toma una posición escéptica contra el análisis de subgrupos y las interacciones. Sucede que corriendo una prueba y otra y otra sobre pequeños subgrupos, se corre el riesgo de terminar  hallando, entre la miríada de tests, falsas asociaciones. Por eso invita a ser especialmente precavido en esta área.

5) Es importantísimo recordar que una cosa es asociación estadística y otra causalidad. Entonces se debe prestar gran atención, particularmente en los estudios observacionales, a la posible espureidad de las asociaciones halladas y a los posibles sesgos en los estudios.


lunes, 15 de febrero de 2016

Como interpretar correctamente los p-valores ("sig"). Texto.


Los p-valores, que frecuentemente aparecen en SPSS bajo el rótulo de "sig", nos indican la probabilidad de obtener un resultado en la prueba de significación (prueba t, chi cuadrado, F, etc.) con valores tan o más extremos como los que se obtuvieron si la hipótesis nula fuera cierta.

No nos dice la probabilidad de que sea cierta la hipótesis nula. El p-valor se calcula a partir del supuesto de que la hipótesis nula es 100% cierta.

Supongamos que tenemos un p-valor de 0.05. ¿Cuál es la probabilidad de que sea cierta la hipótesis nula? No se puede calcular directamente.

Si varias pruebas de significación nos dan p=0.05, esto no significa que en cada una de ellas la probabilidad de que sea cierta la hipótesis nula sea igual. Quizás en algún caso sea muy improbable la hipótesis nula, en particular si hay estudios previos que nos hacen pensar que es falsa. Y quizás en otros casos sea probable, a pesar de nuestro p, si existen numerosos estudios anteriores que nos llevan a pensar que la hipótesis nula es cierta.

Si tenemos un resultado muy poco esperado a la luz de estudios anteriores, muy sorprendente, un valor p menor a 0.05 puede llevarnos a rechazar la hipótesis nula incorrectamente en un gran porcentaje de casos. Si el resultado es muy sorprendente, haremos bien en no sacar conclusiones apoyándonos exclusivamente en el p-valor: debemos tener en cuenta también en estudios anteriores y quizás no emitir un juicio definitivo.

¿Qué podremos hacer para incrementar nuestra confianza en estudios de resultados sorprendentes?
a) replicarlos y b) trabajar con tamaños de muestras mayores.


Añado vínculos a dos interesantes artículos cortos:

http://blog.minitab.com/blog/adventures-in-statistics/not-all-p-values-are-created-equal


http://blog.minitab.com/blog/adventures-in-statistics/five-guidelines-for-using-p-values

miércoles, 10 de febrero de 2016

Tamaño de la muestra, significación estadística, tamaño del efecto, intervalos de confianza y significación práctica: requisitos a la hora de informar los resultados. Texto.


Son varios los requisitos que debe tener un informe de resultados: es deseable que estén los tamaños de la muestra con los cuales se trabaja, y las bases sobre las cuales se calculan los distintos porcentajes; la significación de las relaciones, la fuerza de las asociaciones de variables y los intervalos de confianza.

En algunos investigadores existe una tendendia a centrar la atención excesivamente en si una relación estudiada es estadísticamente significativa o no.

Pero esto cuenta solo parte de la historia.

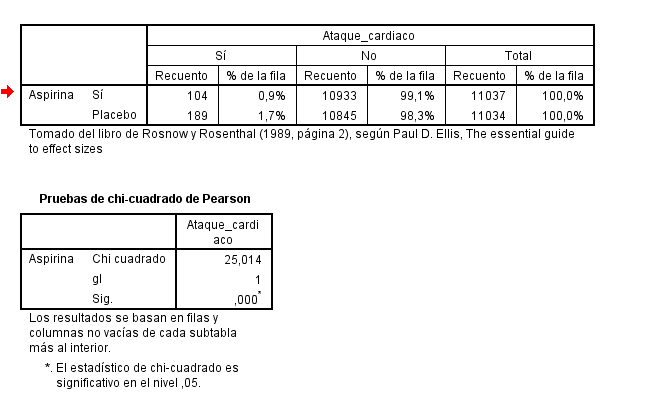
Pongamos el caso del estudio de la aspirina en la prevención de infartos. Si decimos que la relación fue significativa no alcanza: cabe la pregunta sobre qué tan efectiva fue y cuáles son los márgenes de error de la estimación.


En los cuadros anteriores se muestran los números absolutos del estudio, sus porcentajes y el resultado de la prueba de significación chi2. Podemos ver que la Significación de Chi2 es 0.000.

La relación es significativa: podemos rechazar la hipótesis nula de no relación con un alto nivel de confianza.

La relación que se ve en la muestra existe en el universo: no se debe a un azar muestral. O sea, concluímos que en el universo aquellos que tomaron aspirina tuvieron menos ataques cardíacos que aquellos que no la tomaron. Lo que se acaba de decir está bien, pero no alcanza. Hay que ver otros aspectos.

¿Cuánto mejor estuvieron los que tomaron aspirina? Para esto tenemos que usar alguna medida de tamaño del efecto, y esa medida debe ser pertinente y adecuada.

En ciencias sociales frecuentemente usamos la V de Cramer (o también phi, que tiene igual valor que  la V de Cramer pero con signo positivo o negativo) para ver la fuerza en estas asociaciones dicotómicas. Pero como veremos aquí no funcionará muy bien, o si se quiere, no nos ayuda a leer la situación. Sigue la tabla con la V de Cramer:

La V de Cramer es de 0.034. Uno podría pensar que esta cifra es totalmente despreciable: ambas variables parecen muy debilmente asociadas medidas con este coeficiente de asociación. Pero la V de Cramer no funciona bien aquí: en general no funciona bien si una de las variables tiene categorías muy desbalanceadas. Y aquí una de las categorías, la de los infartados es muy pequeña frente a la de no infartados.

En estos casos podemos usar el RR (riesgo relativo). En el grupo de los que toman el placebo, la probabilidad de infartarse fue de 17/1000. En el grupo de los que tomaron aspirina fue de 9/1000. El riesgo relativo fue casi el doble en el grupo placebo: RR = 17 / 9.

Debemos también pensar en las implicacias prácticas de esta asociación, y para ello nos ayudará otra medida del efecto muy intuitiva y adecuada en la situación: el NTT (number needed to treat).

En las cifras de arriba se vio que entre quines tomaban aspirinas, aparecieron 9 infartos cada 1000 personas, y entre quienes tomaron placebo, aparecieron 17 infartos cada 1000 personas. Entonces tenemos derecho a decir que si las 1000 personas del grupo placebo hubieran tomado aspirina, no habría habido 17 infartos sino 9 infartos. Si las 1000 personas del grupo placebo hubieran tomado aspirina se habrían evitado 8 infartos.

Si tratando a 1000 personas evito 8 infartos, entonces NNT = 125.

Por cada 125 personas tratadas con aspirina evito un infarto. Y desde aquí puedo seguir pensando en costos de la intervención, etc. Es una medida de tamaño del efecto que ayuda a comprender la situación práctica, y no es solo una medida comprensible para un estadístico.

NNT no necesariamente debe restringirse a la medicina, puede ser una medida de enorme utilidad al evaluar, por ejemplo, el impacto de políticas públicas. Por ejemplo, a cuántos alumnos tengo que apoyar en sus dificultades educativas para prevenir una deserción.

Otra cosa importa: el intervalo de confianza para la estimación. De una calculadora en línea extraigo:


"The 95% confidence interval for the NNT ranges from 93.2 to 213.3"


O sea, la estimación puntual es que necesitamos tratar a 125 personas: esto es lo que vemos en la muestra. Pero nadie espera que la muestra refleje exactamente al universo de la cuál fue extraída. ¿Entre qué cantidades estará en el universo? Entre 93 y 213, con un nivel de confianza del 95 %

El intervalo de confianza  da una información muy importante, y es qué tan precisa es la estimación.


Otros números relevantes a la hora de informar son los N, los números de casos en que se apoyan los cálculos.

 Así, por ejemplo, se recomienda que los porcentajes siempre reporten la base, el número de casos sobre los cuales se calculan.

 Sigue una tabla bien presentada: con sus porcentajes y sus bases:


Siguen dos trozos de un informe médico. Nótese el abundante uso de los conteos.


Algunos investigadores, si una relación no es significativa, dejan sin informar con precisión aspectos tales como el p-valor, el tamaño del efecto, sus intervalos de confianza, etc.

Esto es equivocado. La relación podría no mostrarse significativa simplemente por el escaso tamaño de la muestra.

Dice Ellis en The Essencial Guide of Effect Sizes: "Report the size and direction of estimated effects. Do this even if results were found to be statistically nonsignificant and your effect size miserably small". "Provide confidence intervals to quantify the degree of precision associated with your effect sizes estimates". "Report the exact p values for all statistical tests, including those with nonsingnificant results".

¿Por qué es importante reportar todos los datos con precisión aún en las relaciones que aparecen como no significativas en nuestro estudio? Porque muchas veces para decidir sobre si ciertas relaciones existen o no, se realizan metaanálisis. Los metaanálisis combinan los resultados de estudios similares para extraer una conclusión de conjunto.


En definitiva:

Para estudiar una relación que vemos en una muestra, es muy deseable tener:
  • su significación
  • su fuerza de la asociación (tamaño del efecto)
  • la importancia práctica de los hallazgos
  • los intervalos de confianza
  • los números base sobre los cuales fueron calculados los estadísticos y porcentajes, y los conteos relevantes.
  • Se debe reportar todo lo anterior, aún si la relación no es significativa.


Notas: 
El calculador utilizado para el cálculo de NTT fue QuickCalcs
Hay pequeñas diferencias en el cálculo de NTT debido a redondeos en el cálculo de los porcentajes originales).


sábado, 6 de febrero de 2016

Primer Parcial Intensivo 2017. Con soluciones escritas.


Se suben ejercicios del primer parcial del curso intensivo 2017.

Se añaden las respuestas de un muy buen estudiante del curso, Andrés Clavier, quien tuvo la gentileza de autorizarme a que subiera su parcial.

Debí modificar un par de preguntas del parcial a posteriori, ya que advertí cierto nivel de ambigüedad en ellas, y por tanto debí modificar las respuestas. Si en los procesos de modificación y ajuste aparecieren errores -espero que no- son enteramente míos.


https://drive.google.com/open?id=1Pi1vJ8yv_PO4oymd9mjrj1fpW910ENUG

viernes, 5 de febrero de 2016

Ejercicios de 1er. parcial año 2007 (sin soluciones).


Exige conocimientos de recodificación de variables, cálculo 0-1, análisis univariado, cálculo condicional, etc.


https://drive.google.com/file/d/0B9C7VyfotFyJX0hYWXJtc0pRODQ/view?usp=sharing

jueves, 4 de febrero de 2016

Ejercicios de 1er. parcial 2015 (sin soluciones)

 El presente archivo corresponde a un primer parcial de SPSS.

El ejercicio 1 es de cálculo 0-1, y de categorización en ntiles.
El ejercicio 2 es de análisis univariado y bivariado.
El ejercicio 3 pide conocimientos de fusión de archivos y de cálculo con variables de cadena.
El ejercicio 4 es de análisis univariado, categorización en ntiles y recodificación
El ejercicio 5 tiene analisis univariado, cálculo y cálculo condicional y recodificación.

Visto lo desarrollado en el blog hasta ahora, todos pueden hacerse excepto el ejercicio 3.


https://drive.google.com/open?id=0B9C7VyfotFyJVVJaSTRCemhpUXM

miércoles, 3 de febrero de 2016

1er. Parcial. Con soluciones escritas.

Primer parcial, con soluciones escritas. Se sugiere hacer el parcial para recién luego comparar soluciones.


https://drive.google.com/open?id=1zz5bX642h4oTnGFoEmuOpALquTvj38y_

lunes, 1 de febrero de 2016

Ejercicio de repaso de análisis univariado y relaciones bivariadas (sin solución)


Base de datos ficticios sobre trabajadoras. Se solicitan descripciones de variables aisladas y de relaciones entre dos variables (gráficas, tablas, pruebas de signficación y tamaño del efecto)


https://drive.google.com/open?id=0B9C7VyfotFyJVnRrSWhlSFZjTmM

sábado, 30 de enero de 2016

Ejercicios de repaso: recodificación, cálculo condicional, análisis univariado y bivariado (sin soluciones).


En el archivo adjunto hay cuatro ejercicios que repasan buena parte de lo visto hasta ahora. Son ejercicios similares a algunos de los que constituirán el primer parcial.

https://drive.google.com/open?id=0B9C7VyfotFyJQW9rUW03ZFpWMUU

martes, 26 de enero de 2016

Ejercicio sobre azulejos. Relaciones bivariadas, fuerza y significación. Con solución escrita


En este ejercicio se analizan relaciones bivariadas, su fuerza y significación, y se realizan cálculos con y sin condiciones.


Problema

Solución

lunes, 25 de enero de 2016

Test H de Kruskal Wallis, una alternativa no paramétrica a ANOVA de una vía. Texto.


El test H de Kruskal Wallis es similar al test de ANOVA de una vía, pero en vez de utilizar las medidas recogidas, se usan los rangos. Se usa Kruskal Wallis, y no ANOVA, si la variable dependiente es ordinal o no es normal.

Hay estadísticos que reservan el test de Kruskal Wallis exclusivamente para cuando además de tener distribuciones no normales o heterocedásticas, los grupos difieren fuertemente en tamaño: en estas condiciones ANOVA es menos resistente a la violación de supuestos.

Kruskal Wallis permite comparar dos o más grupos independientes. ¿Qué se compara? Las medianas si la forma de las distribuciones es igual en los distintos grupos. Y si las formas de las distribuciones son distintas se compara el promedio de los rangos.

El test H de Kruskal Wallis es un test omnibus. El dirá si todos los grupos tienen la misma mediana (si las formas de las distribuciones son iguales) o si tienen el mismo promedio de rangos. Pero si no lo tienen, no indica entre qué grupos se dan las diferencias.

Si la prueba H de Kruskal Wallis dice que hay diferencias, habrá que realizar análisis post hoc para identificar entre qué grupos hay diferencias.


Premisas del test

1) La variable dependiente debe ser ordinal o de escala.

2) La variable independiente debe ser una variable categórica con dos o más grupos.

3) Las observaciones deben ser independientes dentro de cada grupo y entre grupos.

4) Para considerar el test como una comparación de medianas, las distribuciones de cada uno de los grupos deben tener la misma forma grosso modo y similar y dispersión. Sigue un ejemplo en que los grupos son aproximadamente similares.


Todos los grupos tienen un sesgo positivo, outliers en la zona alta, y el ancho de las cajas no difiere excesivamente.

En estas condiciones podremos considerar al test H de Kruskal Wallis una comparación de medianas.

****
Para ilustrar nuevamente el concepto de formas similares y diferentes, tomaremos un ejemplo de
https://statistics.laerd.com/spss-tutorials/kruskal-wallis-h-test-using-spss-statistics.php, aunque es irrealista esperar tal nivel de igualdad.


El procedimiento en SPSS

Se va a la prueba a través de Analizar > Pruebas no Paramétricas > Cuadros de diálogo antiguos > K muestras independientes


Luego se definen los grupos que se quieren comparar. Aquí compararemos los grupos del 1 al 3.


Y finalmente pedimos los resultados:


En los resultados se ve que el grupo con el rango promedio más alto es el grupo 3, y se ve que hay por lo menos una diferencia entre grupos significativa.


Luego de saber que no todos los grupos tienen iguales rangos promedio, se estudiarán las diferencias entre grupos de a dos. Puede hacerse mediante Kruskal Wallis o mediante la U de Mann Whitney. Probablemente futuras versiones de SPSS permitan hacer estas comparaciones adicionales en forma integrada.


domingo, 24 de enero de 2016

U de Mann Whitney, una alternativa no paramétrica a la prueba t. Texto.


La U de Mann Whitney es una prueba no paramétrica que puede ser usada en vez de la prueba t para grupos independientes, cuando el nivel de medición es ordinal. También cuando el nivel de medición es de escala pero las muestras son chicas y no normales (sesgadas y/o con outliers).

Se usa para testear si los rangos de las observaciones de una muestra son mayores que los de la otra muestra. Si las medias de los rangos de las dos muestras son suficientemente distintas, la prueba arrojará p valores significativos.

Esta prueba puede ser vista como una comparación entre medianas si se asume que ambas distribuciones tienen la misma formal, que no tiene por qué ser normal.

Los tests paramétricos, como las pruebas t y ANOVA, requieren niveles de escala en la variable dependiente, y además distribuciones normales. Los llamados test no paramétricos no tienen estos requisitos, sino requisitos menos rigurosos.

Premisas de Mann Whitney


  • Las muestras son aleatorias.
  • Los casos son independientes dentro de cada muestra y entre muestras.
  • El nivel de medición es por lo menos ordinal.

Si se desease establecer un intervalo de confianza para la diferencia entre las medianas muestrales se necesita una condición adicional:


  • Las distribuciones de las dos poblaciones de las que se extrajeron las muestras son idénticas, aparte de una posible diferencia en la localización de los parámetros.


La prueba U de Mann Whitney no usa las mediciones directamente, sino sus rangos. Todas las observaciones juntas son ranqueadas, y luego se calcula un estadístico, la U de Mann Whitney precisamente, a partir de los rangos.


Cómo se hace la prueba de Mann Whitney en SPSS


Lo primero exploramos los datos. En el ejemplo que sigue ambas muestras son chicas (menores de 30) y que son sesgadas.

Aquí tenemos distribuciones sesgadas y muestras chicas. La U de Mann Whitney aparece como una buena opción.


Lo segundo vamos a Analizar > Pruebas no paramétricas > Cuadro de diálogos antiguos > 2 muestras independientes.


Allí indicamos cuál es la variable que queremos comparar y cuáles son los grupos. A continuación habrá que definir los grupos oprimiendo el botón Definir Grupos.


El botón Exacta nos permite elegir si queremos un cálculo exacto (más demandante computacionalmente) o una aproximación asintótica, o un método Montecarlo, con muestreo y remuestreo.


Y finalmente correremos la prueba y analizaremos los resultados.


Y con esto tomamos nuestra decisión de rechazar o no la hipótesis nula, según el nivel de confianza con el que deseamos trabajar.


Elección entre Mann Whitney y pruebas t

Hay situaciones un tanto intermedias en que unos autores prefieren usar la prueba t, a la que consideran suficientemente robusta como para tolerar algún apartamiento de las premisas sin consecuencias dramáticas, y otros prefieren usar la U de Mann Whitney.

Si la distribución es normal la prueba t tiene la ventaja de que es más potente para rechazar la hipótesis nula.

Ahora bien, incluso para distribuciones normales, la prueba de Mann Whitney requiere apenas más casos para rechazarla. Requiere 100 casos cuando la prueba t necesita 95.

Y si la distribución no es normal, la prueba U es más potente.

Otras sutilezas al momento de elegir entre estas pruebas escapan al contenido de este curso.


sábado, 23 de enero de 2016

Prueba de significación de McNemar, para proporciones en muestras relacionadas. Video e hipervínculo a video ajeno.


El video adjunto muestra el chi cuadrado de McNemar, o simplemente prueba de McNemar, para estudiar la significación de cambios de proporciones en dos muestras relacionadas.

https://drive.google.com/open?id=0B9C7VyfotFyJSjZwS3dPOHhSLW8


Pueden asimismo encontrar un buen video sobre el tema en Youtube:

https://www.youtube.com/watch?v=FNSg4R-YzOc


lunes, 18 de enero de 2016

Relaciones bivariadas, pruebas de significación, fuerza de las asociaciones. Con solución escrita.


Problema que pide estudiar distintas relaciones bivariadas con tema satisfacción laboral.


Problema

Solución

domingo, 17 de enero de 2016

Escuela actoral. Relaciones bivariadas. Sin solución.

Ejercicio de relaciones bivariadas con pruebas de significación y medidas de fuerza de asociaciones.


https://drive.google.com/open?id=1VAg7kYnuOPtMX2GF6po__v_4xJYe18d_

sábado, 16 de enero de 2016

Ejercicio sobre relaciones bivariadas, con pruebas de significación y medidas de fuerza. Temática Aprendizajes. Solución escrita.


Problema que pide estudiar relaciones entre variables nominales, ordinales y de escala, con sus correspondientes pruebas de significación y coeficientes de fuerza de la asociación.


Problema

Solución

viernes, 15 de enero de 2016

Anova de una vía para grupos independientes. Texto e hipervínculos a videos ajenos.

Uso de ANOVA

La prueba de ANOVA de una vía es una prueba de significación. Como todas las pruebas de significación nos ayuda a decidir si hay evidencia suficiente para descartar una hipótesis nula: la de que las medias de tres o más grupos son iguales.

Usamos ANOVA cuando tenemos una variable nominal u ordinal con más de 2 categorías y una variable de escala.

Por ejemplo, podemos querer ver si los años de educación de los votantes de distintos partidos políticos tienen iguales medias. Aquí nuestra variable de escala es años de educación, y nuestra variable nominal es partidos políticos (Partido Colorado, Partido Nacional, Frente Amplio y Partido Independiente).

La hipótesis nula es que todas las medias son iguales. La hipótesis alternativa es que por lo menos una de las medias es diferente.


Supuestos relevantes de ANOVA 

1) Dentro de cada grupo, la variable dependiente se distribuye normalmente (en nuestro ejemplo, los años de educación de los miembros del PC se distribuyen normalmente, también los años de educación del PI, etc.).

Sin embargo, esta prueba tolera moderados alejamientos de la normalidad, especialmente si hay 20 o más casos en cada grupo.

 2) Las varianzas son similares en los distintos grupos.  

Sin embargo, si los grupos tienen igual tamaño, esto no afecta mayormente. Pero además tenemos dos opciones dentro del menú de ANOVA que dan más precisión: los estadísticos de Welch y de Brown Forsythe.

"There are two tests that you can run that are applicable when the assumption of homogeneity of variances has been violated: (1) Welch or (2) Brown and Forsythe test. Alternatively, you could run a Kruskal-Wallis H Test. For most situations it has been shown that the Welch test is best. Both the Welch and Brown and Forsythe tests are available in SPSS Statistics (see our One-way ANOVA using SPSS Statistics guide)".


3) Los casos son independientes.

Por ejemplo, en un estudio observacional han sido elegidos por muestreo aleatorio simple.


Alternativa no paramétrica a ANOVA: test H de Kruskal Wallis

Especialmente en casos de muestras pequeñas no normales, podemos recurrir al test H de Kruskall Wallis. Este test trabaja con los rangos de las observaciones, en vez de las obsercaciones en sí mismas. Del lado positivo, tiene supuestos más débiles. Como contracara, es menos potente a la hora de rechazar la hipótesis nula en caso de que se cumplan los supuestos de ANOVA.


ANOVA de Welch

Hay quienes se incluinan por usar en muchas ocasiones el ANOVA de Welch. Funciona bien en la hipótesis de varianzas diferentes y también en la de varianzas iguales.


Welch’s ANOVA is an elegant solution because it is a form of one-way ANOVA that does not assume equal variances. And the simulations show that it works great!
When the group standard deviations are unequal and the significance level is set at 0.05, the simulation error rate for:
  • The traditional one-way ANOVA ranges from 0.02 to 0.22, while
  • Welch’s ANOVA has a much smaller range, from 0.046 to 0.054.
Additionally, for cases where the group standard deviations are equal, there is only a negligible difference in statistical power between these two procedures. If the data show a lot of heteroscedasticity (different groups have different standard deviations), the one-way anova can yield an inaccurate P value; the probability of a false positive may be much higher than 5%. In that case, you should use Welch's anova.


Pruebas post hoc

La prueba de ANOVA es lo que se llama una prueba omnibus. Se testea si hay evidencia para descartar la hipótesis nula de que todas las medias son iguales entre sí. Pero si ANOVA es significativa, aún no sabemos entre qué medias hay diferencias.

Para identificar entre qué grupos hay diferencias, se hacen las pruebas post hoc. Hay diferentes modos de hacer estas pruebas tanto si se asume igualdad de varianzas como si no se asume. Dos muy usados son a) Tukey, si las varianzas se suponen iguales, y b) Games Howell si no son iguales.


Siguen tres videos cortos extraídos de Youtube. Los dos primeros están en español y muestran lo más típico del análisis de varianza. El tercero es sobre el Anova de Welch y está en inglés, con subtítulos en inglés.