miércoles, 30 de septiembre de 2015
Indices: distintas escalas. Video.
En ocasiones deseamos formar un índice a partir de varios ítems y estos tienen rangos de variación muy distintos (unos varían mucho y otros poco).
En estas circunstancias, si promediamos el que pesa más el que varía más. Si un ítem varía poco prácticamente es como si no existiera.
Si el deseo del investigador es que todos los ítems pesen igual (y este es un deseo bastante usual), hay que modificar los índices matemáticamente para que varíen de forma similar.
Veremos en el video dos formas típidas de hacerlo: con la estandarización Z y con la estandarización 0-1.
Luego calcularemos índices en base a ambas estandarizaciones y veremos hasta donde ordenan los casos de manera similar o no.
https://drive.google.com/file/d/0B9C7VyfotFyJZXhSQnVDbXZHVnM/view?usp=sharing

viernes, 25 de septiembre de 2015
Indice con ítems en distintos sentidos e igual escala. Video.
En el vídeo adjunto, se muestran varios ítems tales que el acuerdo con ellos indica insatisfacción laboral, y un ítem en sentido inverso: el acuerdo imdica satisfacción.
O sea, el puntaje alto casi siempre indica insatisfacción, pero en un ítem es el puntaje bajo que indica insatisfacción.
Para calcular el ítem hay que invertir el que va en sentido contrario a los demás. Aquí los valores van del 1 al 7.
Habrá que calcular un ítem_invertido tal que, cuando el ítem original valga 1, el ítem invertido valga 7; cuando el ítem original valga 2, el invertido valga 6..... y finalmente, cuando el ítem original valga 7 el invertido valga 1.
Finalmente calculamos el índice promedio o el índice sumatorio. El promedio es sencillo de calcular.
Si se desea trabajar con la suma, es mejor sustituirla por el promedio y multiplicarlo por el número de ítems. Es equivalente a la suma si hay valores válidos en todos los casos. Y si faltan algunos ítems, esta forma de calcular parece mejor.
https://drive.google.com/file/d/0B9C7VyfotFyJend2LVJHSlg4dDA/view?usp=sharing
domingo, 20 de septiembre de 2015
Indice. Igual sentido de los ítems. Igual Escala. Video.
En el vídeo adjunto se muestra cómo crear un índice que resuma la información de varios ítems.
Aquí se han puesto 5 afirmaciones supersticiosas y se pide el grado de acuerdo con dichas afirmaciones, donde 1 significa total desacuerdo y 7 significa total acuerdo.
Nótese que para todos y cada uno de los ítems más acuerdo significa más prejuicio: todos los ítems tienen igual sentido.
Nótese también que todos los ítems van del 1 al 7: todos tienen igual escala de variación.
Para construir un índice podemos hacerlo:
a) pidiendo el promedio
b) pidiendo la suma.
¿Qué haremos en el ejercicio con los casos que no tienen toda la información? En el ejercicio calcularemos el índice si hay por lo menos 3 valores válidos. Si tiene menos de 3 no lo calcularemos y el índice arrojará un valor faltante.
Con el total hay que tener cuidado, porque los datos faltantes bajan la suma artificialmente, pero esto tiene solución. Puede ver cómo en el vídeo.
https://drive.google.com/file/d/0B9C7VyfotFyJZEVYbFAxbXFwUTg/view?usp=sharing
martes, 15 de septiembre de 2015
Recodificación de variables numéricas. Video.
La recodificación de variables es una operación básica en el análisis de datos. Generalmente se realiza en otras variables, a fin de no sobreescribir la variable original.
En el video se muestra la recodificación de variables categóricas (nominales u ordinales) y de variables de escala. El procedimiento más flexible es la llamada recodificación en distintas variables.
También se muestran la recodificación de variables de escala en un cierto número de "ntiles" (cuartiles, quintiles, deciles, etc.) y el uso del agrupador visual, muy útil este cuando queremos dividir en gran número de categorías.
El video puede verse en línea en
https://drive.google.com/open?id=0B9C7VyfotFyJUEJKV0ZuMEZvekE
En el video se muestra la recodificación de variables categóricas (nominales u ordinales) y de variables de escala. El procedimiento más flexible es la llamada recodificación en distintas variables.
También se muestran la recodificación de variables de escala en un cierto número de "ntiles" (cuartiles, quintiles, deciles, etc.) y el uso del agrupador visual, muy útil este cuando queremos dividir en gran número de categorías.
El video puede verse en línea en
https://drive.google.com/open?id=0B9C7VyfotFyJUEJKV0ZuMEZvekE
lunes, 7 de septiembre de 2015
Ejercicio de cálculo con condiciones. Tema: elección de película. (Con solución escrita)
Corra la sintaxis entre asteriscos y resaltada en amarillo. Se generará una base de datos.
Para esto en Spss vaya a Archivo, Nuevo, Sintaxis, copie el contenido entre asteriscos y ejecute.
********************************************.
INPUT PROGRAM.
LOOP PeliculaNro=1 TO 400.
END CASE.
END LOOP.
END FILE.
END INPUT PROGRAM.
set seed = 7998.
compute aleat = rv.uniform(0,1).
string genero (a15).
if range (aleat, 0, 0.10) genero = "terror".
if range (aleat, 0.10, 0.25) genero = "policial".
if range (aleat, 0.25, 0.40) genero = "lejano oeste".
if range (aleat, 0.40, 0.60) genero = "romantico".
if range (aleat, 0.60, 0.80) genero = "guerra".
if range (aleat, 0.80, 1) genero = "comedia".
compute duracion_minut = trunc (rv.uniform(60,140)).
compute nacionalidad_director = trunc(rv.uniform(1,8)).
value labels nacionalidad_director 1 "inglés" 2 "norteamericano" 3 "indio" 4 "chino" 5 "latinoamericano" 6 "turco" 7 "otro".
Compute entradas_vendidas = trunc(rv.uniform(5000000, 15000000)).
compute recibio_premios = rv.uniform(0,1) < 0.70.
value labels recibio_premios 1 "Sí" 0 "No".
execute.
delete variables aleat.
execute.
********************************************.
La base de datos generada simula las películas a las que pueden acceder tres amigos.
- El primero, Mario, desea ver una película que no sea de guerra, y con un director que no sea inglés ni norteamericano. ¿Cuántas películas son aceptables para Mario?
- El segundo, Alberto, desea una película que se encuentre en el primer tercil de duración, es decir que sea relativamente corta. ¿Cuántas películas son aceptables para Alberto?
- El tercero, Miguel, quiere ver una película que tenga premios, y que dure entre 70 y 100 minutos (ambos extremos incluidos). ¿Cuántas películas son aceptables para Miguel?
- Los tres amigos confeccionan una lista con las películas aceptables para los tres, y de ellas eligen la que vendió más entradas. ¿Qué película verán, identificada por su número, cuál fue su género, duración y la nacionalidad de su director?
+++++++++++++++++++ Mi solución +++++++++++++++++++
domingo, 6 de septiembre de 2015
Ejercicio de cálculo 0-1 (sin soluciones). App de citas
Ejercicio en donde chicas eligen candidatos posibles para citarse.
https://drive.google.com/open?id=0B9C7VyfotFyJeW94WDFtdnhtWEE
martes, 1 de septiembre de 2015
El asesino del picahielo. Ejercicio de cáculo 0-1. Solución en video.
Ejercicio para identificar a personas que cumplen distintas condiciones, resoluble con cálculo 0-1.
Se invita a intentar resolverlo antes de mirar la solución: esto da el máximo rendimiento desde el punto de vista del aprendizaje.
Base y letra del problema
Solución en video
Se invita a intentar resolverlo antes de mirar la solución: esto da el máximo rendimiento desde el punto de vista del aprendizaje.
Base y letra del problema
Solución en video
domingo, 30 de agosto de 2015
Cálculo 0 - 1. Video.
En este curso llamo "cálculo 0 - 1" a la creación de una nueva variable igualándola a una condición.
Por ejemplo, podemos tener una variable Sexo que tiene dos categorías: 1 para "hombre" y 2 para mujer.
Si calculamos una nueva variable, que podemos llamar Mujer, poniendo
compute mujer = (sexo = 2).
le estamos diciendo a SPSS que la nueva variable toma el valor de una condición que puede ser cierta o falsa. Para cada renglón la condición sexo = 2 puede cumplirse o no. En estos cálculos, cuando la condición se cumple, la nueva variable, en este caso Mujer, toma el valor 1, en caso de que no se cumpla toma el valor 0.
Un segundo ejemplo: Si en nuestra base tenemos la variable Partido_que_Votó, con las categorías de respuesta 1 "FA", 2 "PN", 3 "PC", 4 "PI" y 5 "AP", podriamos calcular una nueva variable llamada frenteamplista así:
compute frenteamplista = (Partido_que_Votó = 1).
Para los que votaron al FA, la condición es cierta y la nueva variable tomará el valor 1. Para el resto de los casos, la condición es falsa y la nueva variable tomará el valor 0.
En resumen, si calculamos una nueva variable y decimos que es igual a una condición, va a poner 1 o 0. Pondrá 1 si la condición es cierta, y 0 si es falsa.
El video que sigue detalla esta forma de cálculo.
https://drive.google.com/open?id=0B9C7VyfotFyJZXZic2lYNk0xUUE
Por ejemplo, podemos tener una variable Sexo que tiene dos categorías: 1 para "hombre" y 2 para mujer.
Si calculamos una nueva variable, que podemos llamar Mujer, poniendo
compute mujer = (sexo = 2).
le estamos diciendo a SPSS que la nueva variable toma el valor de una condición que puede ser cierta o falsa. Para cada renglón la condición sexo = 2 puede cumplirse o no. En estos cálculos, cuando la condición se cumple, la nueva variable, en este caso Mujer, toma el valor 1, en caso de que no se cumpla toma el valor 0.
Un segundo ejemplo: Si en nuestra base tenemos la variable Partido_que_Votó, con las categorías de respuesta 1 "FA", 2 "PN", 3 "PC", 4 "PI" y 5 "AP", podriamos calcular una nueva variable llamada frenteamplista así:
compute frenteamplista = (Partido_que_Votó = 1).
Para los que votaron al FA, la condición es cierta y la nueva variable tomará el valor 1. Para el resto de los casos, la condición es falsa y la nueva variable tomará el valor 0.
En resumen, si calculamos una nueva variable y decimos que es igual a una condición, va a poner 1 o 0. Pondrá 1 si la condición es cierta, y 0 si es falsa.
El video que sigue detalla esta forma de cálculo.
https://drive.google.com/open?id=0B9C7VyfotFyJZXZic2lYNk0xUUE
sábado, 29 de agosto de 2015
Ejercicio sobre curva Roc. Sin solución
Se presenta base con pacientes con tumores y dos potenciales marcadores que se pide sean comparados.
Ejercicio
Ejercicio
viernes, 28 de agosto de 2015
Curvas ROC. Video
Las curvas ROC sirven para evaluar pruebas diagnósticas continuas de enfermedades dicotómicas (si/no). Grafican la sensibilidad versus los falsos positivos para distintos puntos de corte posibles.
Por ejemplo, podemos pensar que un marcador tumoral nos va a servir para predecir adecuadamente la presencia o no presencia de un tumor. La curva Roc, a través de la AUC (área bajo la curva), nos permite saber si es un buen marcador o no.
En términos convencionales, según su AUC, un test es:
Por ejemplo, podemos pensar que un marcador tumoral nos va a servir para predecir adecuadamente la presencia o no presencia de un tumor. La curva Roc, a través de la AUC (área bajo la curva), nos permite saber si es un buen marcador o no.
En términos convencionales, según su AUC, un test es:
- .90-1 = excelente
- .80-.90 = bueno
- .70-.80 = razonable
- .60-.70 = pobre
- .50-.60 = inadecuado
La curva ROC nos sirve, además para elegir el mejor punto de corte. A veces podemos buscar maximizar simultáneamente la sensibilidad y la especificidad, o a veces, según criterios médicos, podemos darle prioridad a una sobre la otra.
jueves, 27 de agosto de 2015
martes, 25 de agosto de 2015
Variables del tipo "tiempo hasta el evento" Video.
Hay un tipo de variables especiales que requiere dos columnas en SPSS: son las llamadas "tiempo hasta el evento" o "tiempo al evento".
El evento puede ser de muy distinto orden, aunque se verá primero un caso de supervivencia, porque al menos en medicina se emplea con mucha frecuencia para analizar supervivencia.
En nuestro ejemplo habrá dos variables: una que nos dice cuanto tiempo pasa hasta un evento (muerte en nuestro caso) a partir de un cierto momento (infarto).
Pero no en todos los casos se producirá la muerte. A veces se producirá, y esto lo marcaremos con un 1 en una segunda variable que llamaremos evento. A veces no se producirá, y esto lo marcaremos con un 0.
¿Por qué no se produce el evento muerte en nuestro ejemplo? Básicamente por dos razones: la primera es que se produce el fin del estudio y la persona sigue viva, y la segunda que alguna gente fue observada pero luego "se perdió de vista". Por ejemplo, el infartado que veníamos estudiando se fue del país. Estas observaciones en las que no se produce el evento se llaman "observaciones censuradas".
¿Cómo se describe gráficamente un cierto tiempo hasta el evento? Una de las maneras más habituales es mediante el gráfico de Kaplan Meier.
También pueden usarse cuartiles de supervivencia: cuanto tiempo pasa para que fallezca por ejemplo el 25 % y sobreviva exactamente el 75 %. Pueden usarse otros cuartiles (mediana y percentil 25).
Estos análisis de tiempo hasta el evento pueden usarse también en ciencias sociales. Por ejemplo, podemos hacer un estudio de reincidencia en el delito de presos liberados. ¿Cuánto tiempo pasa antes de que hayan reincidido el 10%, o el 25%, etc.? Aquí habrá observaciones censuradas: algunos no reincidirán, al menos durante la duración del estudio y otros serán perdidos de vista.
Y también puede usarse para eventos favorables. ¿Cuánto tiempo pasa para que una pareja recién formada tenga su primer hijo? Nuevamente habrá observaciones censuradas: parejas que no tienen hijos durante la duración del estudio o que se disuelven antes de tener algun hijo.
En el video se muestra el aspecto de estas variables que requieren dos columnas, y la forma en que se describen en SPSS.
https://drive.google.com/file/d/0B9C7VyfotFyJMGdrSlRnNldKWG8/view?usp=sharing
jueves, 20 de agosto de 2015
¿Puede ser tratada una distribución como aproximadamente normal? Pequeño texto.
Hay diversas pruebas estadísticas que pueden ser aplicadas si una distribución es "aproximadamente normal".
Pero no es unívoco a qué llamamos "aproximadamente normal".
Métodos gráficos
Algunos estadísticos se inclinan por una inspección gráfica de la muestra. Si el histograma es aproximadamente simétrico y unimodal, algo acampanado, les alcanza para decir que proviene de una población aproximadamente normal, o al menos para no descartar la hipótesis nula de normalidad de la población.
Otros estadísticos piden curvas QQplot y PPplot, que grafican percentiles esperados para una distribución normal y los percentiles observados en nuestra muestra. Si la nube de puntos no se aleja demasiado de la diagonal y si no hay outliers extremos, damos la distribución por normal. En SPSS las curvas QQplot y PPplot pueden ser encontradas en Analizar, Estadísticos descriptivos, gráficos PP y QQ.
¿Qué es una distribución no normal? Esencialmente distribuciones bimodales o trimodales, distribuciones fuertemente sesgadas, ya sea a izquierda o a derecha, o distribuciones con outliers muy marcados.
Métodos que usan el coeficiente de asimetría o de curtosis.
Hay autores que deciden tratar a una curva como normal o no según sean sus medidas de asimetría y curtosis. En SPSS se pueden pedir estas medidas así: Analizar, Estadísticos descriptivos, Explorar.
Ahora bien, ¿qué es aproximadamente normal? Parecen haber grandes diferencias entre autores.
Encuentro en la red una propuesta de considerar normal una distribución si ambos coeficientes caen en el entorno de ± 0.5:
Cuando la distribución de los datos cuenta con un coeficiente de asimetría (g1 = ±0.5) y un coeficiente de Curtosis de (g2 = ±0.5), se le denomina Curva Normal. Este criterio es de suma importancia ya que para la mayoría de los procedimientos de la estadística de inferencia se requiere que los datos se distribuyan normalmente
(Tomado de http://www.spssfree.com/curso-de-spss/analisis-descriptivo/medidas-de-distribucion-curtosis-asimetria.html).
**
En cambio, otros autores usan los límites de ± 1 y de ± 2 para las medidas de asimetría y curtosis. Hasta 1 muy bueno, al menos para cálculos psicométricos y hasta 2 aceptable.
- Kurtosis: a measure of the "peakedness" or "flatness" of a distribution. A kurtosis value near zero indicates a shape close to normal. A negative value indicates a distribution which is more peaked than normal, and a positive kurtosis indicates a shape flatter than normal. An extreme positive kurtosis indicates a distribution where more of the values are located in the tails of the distribution rather than around the mean. A kurtosis value of +/-1 is considered very good for most psychometric uses, but +/-2 is also usually acceptable.
- Skewness: the extent to which a distribution of values deviates from symmetry around the mean. A value of zero means the distribution is symmetric, while a positive skewness indicates a greater number of smaller values, and a negative value indicates a greater number of larger values. Values for acceptability for psychometric purposes (+/-1 to +/-2) are the same as with kurtosis.
Measures of the shape of the distribution
(measures of the deviation from normality)
(Tomado de http://psychology.illinoisstate.edu/jccutti/138web/spss/spss3.html)
Métodos que usan pruebas de significación para establecer normalidad.
Spss ofrece hacer pruebas de significación para intentar rechazar la hipótesis nula de distribución normal (Analizar, Estadísticos Descriptivos, Explorar, Gráficos, Gráficos con pruebas de normalidad). Las pruebas realizadas son las de Kolmogorov-Smirnov y la de Shapiro-Wilk.
Pero estas pruebas también tienen sus inconvenientes. Si la muestra es muy chica, aunque sea extraída de una distribución nada normal, es probable que la prueba no alcance los umbrales de significatividad (La prueba "no está segura" de rechazar la hipótesis nula de normalidad simplemente porque la muestra es muy chica).
Las pruebas de significación tampoco funcionan bien con las muestras grandes. Si una muestra está apenas alejada de lo normal, pero la muestra es de gran tamaño, la prueba de significación puede "estar segura" de que la distribución no es perfectamente normal. Y aunque nuestra muestra no fuese exactamente normal, es muy probable que pudiese recibir tests que tengan entre sus premisas la normalidad.
Hay autores que recomiendan la inspección visual y una prueba de significación. Entre Kolmogorov Smirnov y Shapiro-Wilk, le dan prioridad a la última por considerarla más sensible.
En conclusión:
Hay varias formas para expedirse sobre la normalidad aproximada de una muestra. Ninguna es totalmente satisfactoria en todas las circunstancias. Ni la gráfica, ni las pruebas de significación, ni los valores de asimetría y curtosis.
Ante la duda acerca de la normalidad de una población de la cual se extrae una muestra, podemos analizarla de dos formas distintas: como si procediera de una población normal y como si viniese de una población no normal. Si se arriba a conclusiones similares en ambos análisis, deja de ser importante si es normal o no.
En otras ocasiones lo mejor es fijarse en el área específica que se está trabajando. Si se desea hacer un indicador en psicología, habría que ver qué criterios usan quienes arman indicadores en psicología.
sábado, 15 de agosto de 2015
Análisis univariado. Ejercicio (sin soluciones) sobre el Archivo de Personas de la ECH
En este ejercicio se piden descripciones univariadas de variables continuas y categóricas.
También se piden descripciones de variables tales que sólo recogen información en algunos casos. Por ejemplo, una de las preguntas a mujeres mayores de 14 años es cuántos hijos tuvieron nacidos vivos. Estas preguntas no se hacen a hombres ni a mujeres de 14 años o menos. ¿Cómo maneja la ECH estas situaciones.
El archivo adjunto contiene una base recortada de personas de la ECH 2014, un cuestionario para poder entender bien qué se preguntó, un libro de códigos y un archivo de texto con las preguntas a contestar.
https://drive.google.com/file/d/0B9C7VyfotFyJOTc1TkZJRnMwcTA/view?usp=sharing
lunes, 10 de agosto de 2015
Ejercicio de análisis univariado. Video.
Se adjuntan a este mail una base de datos y la letra de un ejercicio. También se adjunta un vídeo con la solución,
Se lo invita a que descargue a su computadora los archivos adjuntos. A partir de la base y el documento .doc podrá hacer el ejercicio por usted mismo. Luego, si lo desea, verifique su solución viendo el vídeo.
https://drive.google.com/open?id=0B9C7VyfotFyJX1c5Q2RGZl83Uzg
miércoles, 5 de agosto de 2015
Análisis Univariado. Video.
La expresión análisis univariado alude al análisis de variables "sueltas", esto es, se estudian las variables de a una sin ver, en esta etapa, su conexión con otras.
En el análisis univariado tenemos dos grandes caminos, que trabajan juntos: el gráfico y el numérico. ¿Qué gráficas? Dependen del nivel de medición. ¿Qué medidas de resumen numérico? Dependen del nivel de medición.
No es lo mismo representar una variable categórica (nominal u ordinal) que una variable de escala.
El siguiente video alude al tema y puede verse en línea:
https://drive.google.com/open?id=0B9C7VyfotFyJWVp3VTNfN0k1bTg
En el análisis univariado tenemos dos grandes caminos, que trabajan juntos: el gráfico y el numérico. ¿Qué gráficas? Dependen del nivel de medición. ¿Qué medidas de resumen numérico? Dependen del nivel de medición.
No es lo mismo representar una variable categórica (nominal u ordinal) que una variable de escala.
El siguiente video alude al tema y puede verse en línea:
https://drive.google.com/open?id=0B9C7VyfotFyJWVp3VTNfN0k1bTg
domingo, 2 de agosto de 2015
Importación de datos desde Excel, con conversión de fechas. Video
En este video se importarán datos desde una planilla un tanto atípica
Además de los nombres de variables y datos hay títulos, y por tanto es necesario especificar desde donde a donde van los nombres de las variables y los datos.
Además se muestra cómo se resuelve un problema habitual al pasar de Excel a SPSS: las fechas de Excel que se ven como números de cinco cifras en SPSS.
Lo anticipo aquí: se usa esta sintaxis:
DO REPEAT d= var_fecha1 var_fecha2 var_fecha3 var_fecha4.
COMPUTE d= date.mdy(1,1,1900) + ((d-2)*24*60*60).
END REPEAT print.
DO REPEAT d=var_fecha1 var_fecha2 var_fecha3 var_fecha4.
FORMATS d(date14).
END REPEAT print.
COMPUTE d= date.mdy(1,1,1900) + ((d-2)*24*60*60).
END REPEAT print.
DO REPEAT d=var_fecha1 var_fecha2 var_fecha3 var_fecha4.
FORMATS d(date14).
END REPEAT print.
sábado, 1 de agosto de 2015
Importación de fechas desde Excel: con frecuencia dan problemas
Cuando se importan fechas desde Excel, es habitual que aparezcan en SPSS como un dígito de 5 números, unas veces en formato numérico y otras en formato cadena.
La manera de solucionarlo es, si las variables están en formato de cadena, pasarlas a formato numérico. Una manera es con el comando alter type, por ejemplo:
Alter type varCadena (f8).
Aquí la variable varCadena es transformada en numérica, con un largo de 8: eso hace el (f8).
****************************
Si el problema fuera con una sola variable de fecha, que aparece como un número de 5 dígitos, hacemos:
COMPUTE Var1 = date.mdy(1,1,1900) + ((Var1 - 2) *24*60*60).
FORMATS Var1 (date14).
Execute.
****************************
Si tenemos varias variables de fecha que no se han leído bien desde Excel sino como números de 5 dígitos, hacemos:
DO
REPEAT d= Var1 Var2 Var3 Var4.
COMPUTE d= date.mdy(1,1,1900) +
((d-2)*24*60*60).
END REPEAT print.
DO REPEAT d= Var1 Var2
Var3 Var4.
FORMATS d(date14).
END REPEAT print.
Execute.
****************************
jueves, 30 de julio de 2015
Importación de datos desde EXCEL. Video.
Si queremos entrar
datos y no disponemos en ese momento de SPSS, podemos entrarlos en
EXCEL y luego abrirlos desde SPSS.
Nos conviene por
simplicidad que:
- no haya nombres de variables repetidos.
- tengamos una tabla rectangular (igual que como se presentan los datos en SPSS)
- que no haya estructuras complejas de títulos, etc. que le hagan perder el caracter rectangular. (si hubiera cartelería podríamos fijarnos en qué celdas están los datos y decírselo al SPSS, pero lo más sencillo es que estén solo los nombres de las variables y los datos.
Se adjunta planilla Excel y video. No pueden ser vistos directamente en línea: deben ser bajados a la computadora del lector y allí descomprimidos.
https://drive.google.com/open?id=0B9C7VyfotFyJeHA2Mnd0RlVFM0U
sábado, 25 de julio de 2015
Ejercicio de cálculo condicional de sueldos de arquitectos e ingenieros (con solución escrita)
Se pide calcular salarios de ingenieros y arquitectos asumiendo diferentes condiciones (conocimiento o no de autocad, calificaciones altas, etc.) y eventuales horas extras.
Letra y base del problema
Mi solución
viernes, 24 de julio de 2015
Ejercicio de cálculo condicional (sin soluciones) acerca de descuentos en artículos de bazar.
Ejercicio de cálculo condicional, en donde se calculan descuentos diferenciales a artículos de bazar. Además se calcula una tipología.
https://drive.google.com/file/d/0B9C7VyfotFyJTHJ6Z29wR0FmMEk/view?usp=sharing
https://drive.google.com/file/d/0B9C7VyfotFyJTHJ6Z29wR0FmMEk/view?usp=sharing
jueves, 23 de julio de 2015
Ejercicio de cálculo con y sin condiciones. Aumentos de sueldo según conocimientos. (con solución escrita)
lunes, 20 de julio de 2015
Seleccionar casos. Video
En este video se muestra cómo seleccionar casos.
En ocasiones tenemos una base con más casos de los que deseamos o necesitamos: por ejemplo tenemos datos de personas de todo el país y solo deseamos estudiar a las de Canelones.
También puede pasar que tengamos una gran base, por ejemplo de clientes de una firma, y deseemos hacer una encuesta de satisfacción al 10% de la base elegido aleatoriamente.
Para este tipo de situaciones y otras similares es apto el procedimiento de seleccionar casos.
Base
Video
En ocasiones tenemos una base con más casos de los que deseamos o necesitamos: por ejemplo tenemos datos de personas de todo el país y solo deseamos estudiar a las de Canelones.
También puede pasar que tengamos una gran base, por ejemplo de clientes de una firma, y deseemos hacer una encuesta de satisfacción al 10% de la base elegido aleatoriamente.
Para este tipo de situaciones y otras similares es apto el procedimiento de seleccionar casos.
Base
Video
Ejercicio de cálculo con condiciones, en base de datos sobre libros (con solucion en video).
Cópiese en ventana de sintaxis el texto que sigue entre asteriscos, y luego córrase. Se creará base de libros.
***************************************************.
INPUT PROGRAM.
LOOP NroLibro=1 TO 6000.
END CASE.
END LOOP.
END FILE.
END INPUT PROGRAM.
SET SEED=3512.
string tema (a15).
Variable labels tema "Tema del libro".
compute aleat = rv.uniform(0,100).
if range(aleat, 0, 20) tema = "geografía".
if range(aleat,20, 60) tema = "policial".
if range(aleat, 60, 90) tema = "historia".
if range(aleat, 90, 100) tema = "otro".
if rv.uniform(0,1) < 0.15 tema = "".
compute precio_lista = trunc(rv.uniform(76, 140)).
Variable labels precio_lista "Precio de lista".
compute sexoAutor= rv.binom(1, 0.7).
Variable labels sexoAutor "Sexo del autor".
value labels sexoAutor 0 "Mujer" 1 "Hombre".
if rv.uniform(0,1) > 0.1 añoPublicacion = trunc(rv.uniform(1992, 2018)).
execute.
***************************************************.
Un librero considera hacer varios descuentos alternativos.
- Cree una variable llamada "Dto_tema" que establezca un descuento del 10% tanto a libros de geografía como policiales. Si no está establecido el tema, se descontará el 15 %.
- Si aplicara este descuento a los libros y se vendieran todos, ¿cuánto dinero descontaría el librero?
- Cree una segunda variable llamada Dto_autorFem. será el 15% del precio de lista para los libros escritos por mujeres.
- Etiquete mediante sintaxis la variable Dto_autorFem "Descuento a libros de mujeres".
- Si el librero aplicara este descuento, ¿cuánto dinero descontaría?
- El librero también considera descontar $ 50 a los libros anteriores al año 2000, y $ 70 a los libros de los cuales la fecha de creación es faltante.
- ¿Cuánto le costaría efectuar este descuento?
- Finalmente se decide a descontar a cada libro el máximo descuento de los considerados para ese libro. Calcule el descuento.
- Calcule el precio final con descuento de cada libro.
- Indique la media de los precios finales con descuento.
Después de intentar hacer el ejercicio por usted mismo, puede ver mi solución en video:
domingo, 19 de julio de 2015
Ejercicio de cálculos con y sin condiciones, sobre impuestos y subsidios a hogares. Video.
Ejercicio simple donde se muestra cómo crear nuevas variables a veces sin condiciones y a veces con ellas.
Trata de hogares a las que se les cobran impuestos y a los que se les dan subsidios en función de sus características.
https://drive.google.com/open?id=0B9C7VyfotFyJNzU4LVJBalZmWDQ
miércoles, 15 de julio de 2015
Cálculo de variables (con y sin condiciones). Video
El cálculo de nuevas variables es una habilidad absolutamente imprescindible para manejar SPSS.
A veces ese cálculo es el mismo para todas las observaciones de la base. Por ejemplo, si tenemos todos los sueldos en pesos y los queremos pasar a dólares, dividimos todos los valores por la cotización del dolar ($ 28 aprox. al día de hoy).
Pero hay veces en que los distintos renglones se calculan de forma distinta. Si mi base alude a distintos artículos que pagan IVA de forma diferente, según el artículo será el cálculo. Para los que paguen IVA básico, el precio del impuesto será aprox. el precio del producto por 0.10. Para los que paguen el IVA usual, será precio * 0.22 (si hubiera errores en los montos del impuesto esto es irrelevante en lo que hace a nuestro tema). Aquí lo que importa es: cuando hacemos cálculo con condiciones, se calcula con ciertas fórmulas en unos casos y con otras en otro. Y las condiciones hay que aclararlas.
Este video puede ser visto en línea:
https://drive.google.com/open?id=0B9C7VyfotFyJUHJCVkpHa2YxbG8
A veces ese cálculo es el mismo para todas las observaciones de la base. Por ejemplo, si tenemos todos los sueldos en pesos y los queremos pasar a dólares, dividimos todos los valores por la cotización del dolar ($ 28 aprox. al día de hoy).
Pero hay veces en que los distintos renglones se calculan de forma distinta. Si mi base alude a distintos artículos que pagan IVA de forma diferente, según el artículo será el cálculo. Para los que paguen IVA básico, el precio del impuesto será aprox. el precio del producto por 0.10. Para los que paguen el IVA usual, será precio * 0.22 (si hubiera errores en los montos del impuesto esto es irrelevante en lo que hace a nuestro tema). Aquí lo que importa es: cuando hacemos cálculo con condiciones, se calcula con ciertas fórmulas en unos casos y con otras en otro. Y las condiciones hay que aclararlas.
Este video puede ser visto en línea:
https://drive.google.com/open?id=0B9C7VyfotFyJUHJCVkpHa2YxbG8
martes, 14 de julio de 2015
Operadores lógicos y relacionales. Video

Los operadores lógicos y relacionales son los usados a la hora de establecer condiciones para los cálculos, o a la hora de filtrar la base.
******
Imaginemos que tenemos dos variables en nuestra base que son Sexo (1 "Hombre" y 2 "Mujer) y una variable altura (1 "Alto" 2 "Bajo")
Queremos seleccionar a las mujeres altas. ¿Cómo lo expresamos en lenguaje SPSS?
Así:
(Sexo = 2 & altura = 1)
El símbolo & (ampersand) se usa cuando se desean dos condiciones simultáneas.
******
Imaginemos que tenemos las variables Sexo (1 "Hombre" y 2 "Mujer) y la variable peso en kg.
Deseamos seleccionar hombres que pesen más de 70 kg y menos de 90 kg. ¿Cómo los seleccionamos?
(sexo = 1 & peso > 70 & peso < 90)
******
Tenemos las variables Partido_político (1 "FA", 2 "PN" 3 "PC" 4"PI" y 5 "AP"), HablaIngles (1 "Si", 2 "No") y HablaAleman (1 "Si" 2 "No")
Queremos seleccionar personas que no sean del PC. ¿Cómo las pedimos?
(Partido_politico ~=3) (nota: el símbolo ~= se lee "distinto")
**
Queremos frenteamplistas que hable inglés y no hable alemán. ¿Cómo lo pedimos?
(Partido_Politico = 1 & HablaIngles=1 & HablaAleman = 2)
**
¿Y si quisiéramos personas que hablen inglés o aleman y que sean del partido independiente?
((HablaIngles = 1 | HablaAleman = 1) & Partido_político = 3)
**
¿Y si quisieramos No Frenteamplistas que hablen inglés?
(Partido_político ~= 1 & hablaingles = 1)
**
¿Y si quisiéramos miembros del PN que hablen alemán?
(Partido_político = 2 & HablaAleman = 1)
¿Y cómo podríamos seleccionar a los que no cumplen con la condición anterior, es decir, que no son del partido político 2 y a la vez hablan aleman?
~ (Partido_político = 2 & HablaAleman = 1)
(El símbolo ~ se lee "no". Como anticipa a una condición en paréntesis, elige a todos los que no cumplen dicha condición.
**
Y si desearamos seleccionar aquellos casos en que la variable var1 está faltante, ¿cómo pediríamos dicha condición?
missing(var1)
Por ejemplo:
if missing (var1) var3 = 15
significa que si var1 falta, var3 tomará el valor 15.
**
Si queremos seleccionar aquellos casos en que el partido político toma los valores 1, 2 o 3, ¿Cómo hacemos?
Tenemos dos alternativas:
a) ppol = 1 | ppol = 2 | ppol = 3
b) any (ppol, 1, 2, 3)
Las expresiones a) y b) son equivalentes. Son ciertas cuando la variable ppol toma el valor 1, o 2, o 3. La ventaja de la expresión con "any" es que con frecuencia es más compacta.
******
Usted puede disponer de un video que muestra cómo se opera en SPSS y el archivo .sav sobre el cual se operó. Están comprimidos en un rar.
Para ver el video y usar la base, usted debe descargar a su computadora el archivo rar: no es posible utilizar ni el video ni la base en línea.
lunes, 13 de julio de 2015
Asignar Rangos a Casos (Video)
Se muestra video en el que se explican las posibilidades principales que abre la opción Asignar Rangos a Casos del menú Transformar.
Se explica someramente qué son los rangos o rankings, los Ntiles y los rangos fraccionales como porcentajes.
Se adjunta video y base de datos, que deben ser bajados al computador del lector para operar.
https://drive.google.com/open?id=1_75eML_JilddlUAJnWVDXGt7r4Wl_93Z
viernes, 10 de julio de 2015
ECH: algunos errores a evitar
La ECH 2016 y anteriores, tienen algunos aspectos que pueden inducir a error a los analistas, y que conviene conocer.
Los 9 como códigos de inicio de ciclo en educación

En la pregunta e51_4 se pregunta por cantidad de años aprobados en Ciclo Básico. Una persona puede tener de 0 a 3 años aprobados, pero sin embargo aparece un 9.
Ese 9 realmente no significa que tenga nueve años aprobados, sino que empezó el ciclo básico pero tiene 0 años aprobados.
(Personalmente me parece un despropósito que a alguien que tiene 0 años aprobados en una pregunta sobre años aprobados se le ponga un 9. Si se deseaba recoger esta información en quienes tenían 0 años aprobados, me parece obvio que se debió incorporar otra variable).
Esta codificación de los inicios de ciclo como 9 se ve en muchas preguntas sobre años aprobados: en escuela, primer ciclo de liceo, segundo ciclo, utu, universidad, etc. Antes de calcular los años aprobados por una persona, hay que recodificar todos estos 9 llevándolos a 0.
Quizás sea de interés señalar que el otro 0 aquí obedece realmente a quienes tienen 0 años aprobados. Esto incluye desde ancianos sin escolarización a niños que aún no tienen edad para haber aprobado.
Los 0 como valores faltantes.
Véase por ejemplo la variable d15, del archivo de hogares. Muestro una frecuencia.

Aquí se pregunta por el uso de los baños en los hogares. Aparecen baños de uso exclusivo del hogar, baños compartidos con otros hogares y 0.
Este 0 significa aquí que no se preguntó, porque el encuestado afirmó que en la casa no había baño. Entonces quedó como un 0.
Informática de la ECH no admite los valores faltantes. Pone 0. Hay que estar atentos cuando se analiza para que esto no cree confusiones.
Una pregunta que podría originar confusiones es la e38.

Nótese que si la persona contesta 1, se pasa a E2, y no corresponde contestar a e38_1. O sea que queda como faltante, e informática del INE pone un 0.
Pero también hay datos 0. Son aquellas personas que no siempre vivieron aquí y que hace menos de un año que viven "aquí".
O sea, a veces el 0 indica que no corresponde la pregunta, y a veces que hace 0 años (menos de un año) que viven en el lugar.
Una buena defensa contra errores
Antes de trabajar con una variable, pida su frecuencia y lea el cuestionario y/o diccionario, especialmente si encuentra algo raro. Esto debería evitarle el 99% de los errores de este tipo.
jueves, 9 de julio de 2015
ECH: El diccionario y el cuestionario son documentos imprescindibles
Para usar adecuadamente la Encuesta Continua de Hogares de un cierto año, hacen falta por lo menos dos documentos: el diccionario de variables y el cuestionario de ese año.
Diccionario de variables
Es una hoja Excel con los nombres de las variables, clasificados por temas. A su vez, hay un diccionario para las variables del archivo de Hogares y otro para las del archivo de personas.

Por ejemplo, en la imagen se ve una parte del diccionario de hogares del año 2016. Las filas resaltadas en azul marcan los grandes temas. El concepto que recogen está expresado en la primera y en la última columna. En la parte violeta están los nombres de las variables. En la tercera columna las respuestas posibles y sus códigos.
Nótese que si buscamos un tema, podemos buscar primero el título azul correspondiente y ver debajo que aspectos precisos se recogieron.
El diccionario correspondiente al archivo de personas es similar.

Nótese que una rápida revisión de los títulos resaltados en azul nos lleva a comprender rápidamente los conceptos medidos en la Encuesta.
Las columnas funcionan igual que en el diccionario de Hogares.
El cuestionario con los nombres de variables

En la imagen superior se ve una parte de una hoja del cuestionario.
Como se ve, hay títulos que indican el área temática y sus subáreas: en este caso Salud, Asse, Seguro Médico Privado y Hospital Policial/Militar.
Se ven también las preguntas precisas y los saltos. Recuadrados en azul están algunos de los nombres de las variables. Hay otros nombres no resaltados aquí.
Es un archivo Pdf. Uno puede buscar palabras clave usando Control_F, lo que abre una ventana de búsqueda.
Una particularidad es que los nombres de las variables están con punto, en vez de con guión bajo, como realmente correspondería.
Por ejemplo, en la imagen se puede ver una variable resaltada E45.1, que en la base es E45_1. Probablemente quienes introdujeron el nombre de las variables optaron por el punto para reducir el espacio necesario para incorporar el nombre.
¿Ambos documentos son imprescindibles?
No en todos los casos, pero casi siempre sí. El diccionario es casi como un resumen, el que además tiene más variables.
Hay variables en la ECH que no se preguntan directamente. Por ejemplo ht11, el ingreso total de los hogares, no se le pregunta directamente a la persona. Se le pregunta por distintas fuentes de ingresos, salarios, jubilaciones, rentas financieras, alquileres, etc., que luego son sumadas en la variable ht11.
Para conocer el significado de estas variables agregadas hay que consultar el diccionario.
A su vez, hay preguntas que no son contestadas porque hay saltos en el cuestionario. A una persona que no terminó ciclo básico de secundaria, no se le pregunta por el ciclo secundario superior, etc. La estructura de saltos, y la formulación exacta de las preguntas se comprende mucho mejor mirando el cuestionario.
¿Hacen falta otros documentos para interpretar la ECH?
En ocasiones, sí. Por ejemplo, las áreas de estudio, las ramas de trabajo, etc., están clasificadas y numeradas en documentos separados llamados Codificadores, también disponibles en el sitio web del INE.
También en ocasiones puede ser conveniente usar el Manual del Entrevistador, que es el conjunto de instrucciones dados al encuestador sobre cómo entender las distintas preguntas.
miércoles, 8 de julio de 2015
Encuesta continua de Hogares (ECH): Ponderadores
ECH:
Usar
siempre ponderadores para obtener resultados de análisis.
Para obtener resultados de
análisis con la Encuesta Continua de Hogares hay que usar el
ponderador adecuado.
¿Qué son los ponderadores?
Los ponderadores son variables que dicen a cuántos casos representa cada renglón.
Si trabajamos con la base
correspondiente a todo el año, el ponderador adecuado es
Pesoano.
Si seleccionamos solamente
los casos pertenecientes a un trimestre, el ponderador
adecuado es Pesotrim.
Si seleccionamos los casos
de un solo mes, por ejemplo noviembre, el ponderador es
Pesomen.

En la imagen de arriba se muestran las variables pesoano, pesomen y pesotri. Para el segundo caso de la pantalla pesoano vale 33. Eso quiere decir que si tenemos la base de todo el año, el segundo renglón representa a 33 casos iguales a él. Por ejemplo, si fuera el caso de una mujer de 80 años del departamento de Florida, ese renglón representaría 33 mujeres de 80 años del departamento de Florida.
Si solamente seleccionáramos un trimestre: digamos el primero (meses 1 a 3), ese caso representaría a 134 casos iguales a él.
Y si solamente eligiéramos un mes, por ejemplo seleccionado a Marzo, ese caso representaría a 370.
Los ponderadores requieren de un cálculo especializado que realizan los estadísticos, y obedece a que la muestra se realiza en diferentes etapas y a que hay grupos de los cuales se extraen muestras porcentaulmente más grandes que de otros.
¿Cómo de ponderan casos, por ejemplo con el ponderador el año Pesoano?
Con Datos, Ponderar Casos, y se elige como variable de frecuencia Pesoano.

¿Cómo nos damos cuenta de que la base está ponderada?
De dos maneras. La primera es porque en la base de la pantalla de SPSS dice Ponderación Activada.
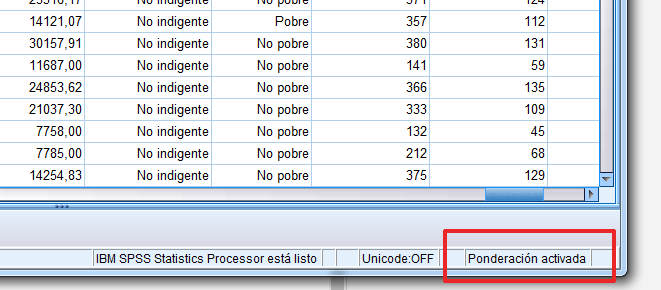
Además nos damos cuenta de una segunda manera de que la base está ponderada. La base de todos los hogares, debe valer aproximadamente 1.200.000 hogares, que son los que hay en el país, y si estamos viendo la base de personas, debemos ver aproximadamente 3.400.000, que es el número de personas que hay en el país.
Por ejemplo, aquí estoy trabajando con el archivo de hogares y pido una distribución del tipo de materiales en paredes. He aquí los resultados que obtengo:

Esto está bien. Tengo toda la base de hogares, pido una frecuencia del tipo de viviendas de todos los hogares de Uruguay y me da 1.234.000, la cantidad de hogares de Uruguay.
Y si estoy en la base de Hogares y Personas, o en la de personas, me tiene que dar aproximadamente 3.400.000.

Aquí veo que todo está bien.
También estaría bien si tuviera seleccionado sólo Montevideo y tuviera aproximadamente 1.300.000 personas, porque esta es la cantidad de personas que hay en Montevideo.

¿Hay ocasiones en que hay que desponderar la base de la ECH?
Sí. Hay dos situaciones.
1) Quiero saber el tamaño real de la muestra.
Si deseo saber en un año sobre cuántas mujeres realmente se pidió información, tengo que quitar el ponderador, o lo que es lo mismo, desponderar.
Presentaré a continuación la cantidad de mujeres que fueron realmente entrevistadas en todo el país:

En todo el país, realmente se tiene información directa de 63.000 mujeres, que representan a todas las uruguayas (aproximadamente 1.800.000)
2) Debo trabajar con aggregate.
Si tengo que trabajar con aggregate es probable que deba desponderar.
Esto es así porque si un hogar tiene por ejemplo 2 sueldos, pero yo le indico al programa que representan digamos 50, si le pido que me los sume, me va a sumar 50 sueldos de cada uno, y va a dar una suma que no es lo que deseo.
Siempre que trabaje con aggregate, me conviene verificar con Analizar, Resumenes de Casos, a ver si los resultados que estoy obteniendo son los que deseo obtener.
martes, 7 de julio de 2015
Cómo bajar los microdatos de la Encuesta Continua de Hogares (Uruguay)
A efectos de bajar las bases de la ECH, es necesario ir al sitio del INE (www.ine.gub.uy) y allí seleccionar base de datos.

Una vez oprimido el botón de bases de datos, se va a Encuesta Continua de Hogares.

Dentro de la Encuesta Continua de Hogares, se elige el año cuyos datos se desean bajar.

Por ejemplo, una vez abierto el 2016 se ofrecen varios archivos. Los imprescindibles probablemente sean a) las bases en formato sav (de spss), c) el diccionario de variables y c) el cuestionario. Para no encontrarse con sorpresas, es aconsejable leer u ojear el resto de la documentación que acompaña la base.
Insisto: no alcanza con bajar los microdatos. Como mínimo bajar el cuestionario y el diccionario de variables.

Con los archivos citados, bases, cuestionario y diccionario, se pueden procesar la mayoría de los datos de la ECH.
En ocasiones pueden necesitarse también los codificadores, que asignan números a las distintas opciones de estudios, ramas de actividad, etc.
lunes, 6 de julio de 2015
Primera presentación de la ECH. Ejercicio de reconocimiento de variables.
Presentación
brevísima de la Encuesta continua de Hogares
La Encuesta Continua de
Hogares se realiza continuamente, día tras día, desde 1968.
Desde el año 2006 cubre todo el país: zonas urbanas y rurales. Actualmente se relevan unos 40.000 hogares cada año, que corresponden a unas 120.000
personas.
Los microdatos recogidos se organizan en tres archivos: uno de ellos
es el de Hogares, con el cuál se trabajará en este ejercicio.
Tiene informaciones relativos a ellos, tales como tipo de vivienda,
ingresos totales del hogar, etc. Un segundo archivo es el de Personas. Tiene datos referidos a las
personas, tales como edad y educación. Un último, el archivo Fusionado, se obtiene simplemente juntando la
información de los dos anteriores.
Para usar los microdatos hace falta la información de varios documentos. Dos de los más relevantes son:
a) libro de códigos (hoja excel que indica los nombres de las variables, su contenido y su codificación)
b)el cuestionario con los nombres de las variables.
Contenido del ejercicio
En el ejercicio se exploran algunas de las variables del archivo de hogares, y se pregunta por su forma de almacenamiento, por sus niveles de medición, su contenido. También se solicitan algunas frecuencias y gráficas.
En vínculo que sigue contiene
a) un archivo reducido de hogares, de la ECH 2014.
b) un libro de códigos (archivo excel con contenido de variables)
c) el cuestionario 2014 de la ECH
d) la letra del ejercicio.
Bájelos a su computadora y ábralos para hacer el ejercicio.
domingo, 5 de julio de 2015
Entrada de datos. Video
Usualmente no se entran datos directamente en SPSS, salvo que sean unos pocos. Muchas veces analizamos datos ajenos (por ejemplo de la Encuesta Continua de Hogares) o entrados con otros programas (por ejemplo Excel).
Si hemos de entrar una gran cantidad de datos de manera habitual, lo mejor es manejar algún programa especializado en la entrada de datos. Tres buenos programas gratuitos son EPIDATA, EPIINFO y CSpro.
De todas formas tiene mucho sentido ver cómo se entran los datos directamente en SPSS, entre otras razones porque nos permite comenzar a familiarizarnos con sus pantallas, con los requerimientos para los nombres de las variables, con los niveles de medición, etc.
Pueden bajar un video y un archivo docx para verlos en su computadora en:
https://drive.google.com/open?id=0B9C7VyfotFyJb2txU2NFLWpxRnM
Tiene que bajar ambos archivos: no pueden verlos en línea. La idea es que a partir del docx puedan replicar la entrada de datos.
martes, 30 de junio de 2015
Rúbrica para evaluación de los parciales
| Rúbrica para la puntuación de los parciales | ||||
| Puntaje mínimo de aprobación | Puntaje máximo | |||
| Elección de estadísticos, gráficas y procedimientos adecuados | Al menos en el 70% aproximadamente de los casos, se elije el procedimiento adecuado. | Se eligen siempre procedimientos y gráficas dentro de los adecuados. | ||
| Interpretación pertinente de los resultados | Al menos en el 70% de los casos no hay errores serios de interpretación. | Se interpretan adecuadamente los resultados más relevantes: no hay errores de interpretación. Se prefieren respuestas cortas y al punto. | ||
| Ejecución precisa de cálculos, fusiones, etc. | Al menos en el 60% de los casos, la ejecución es precisa | No hay errores con paréntesis, nombres de variables, etc. | ||
| Trabajo ordenado y claro: variables, categorías y gráficos rotulados con nombres adecuados. Sintaxis fácil de comprender. Texto redactado luego de la especificación de las preguntas. | La sintaxis y su redacción puede tener puntos oscuros, pero mayoritariamente el trabajo debe ser comprensible. | El trabajo se lee fácilmente, y está bien rotulado en sus variables, cuadros, etc. Las tablas son prolijas. | ||
Suscribirse a:
Entradas (Atom)